Le 22 octobre 2026, Hugging Face et ses partenaires ont rendu public Carbon-X, un modèle ouvert qui associe séquences d’ADN et langage courant. L’enjeu n’est pas de remplacer le laboratoire : il est de permettre aux chercheurs d’interroger plus directement des données biologiques. Une promesse qui exige de distinguer capacité de calcul et validation scientifique. [1][2]
Lire une séquence ne suffit pas à la comprendre
L’ADN repose sur quatre bases, désignées par les lettres A, C, G et T. Leur ordre porte l’information biologique. Comme l’explique le National Human Genome Research Institute, le séquençage consiste à établir cet ordre à partir de fragments, puis à reconstruire informatiquement la séquence. L’analyse intervient ensuite : produire des données et déterminer leur signification sont deux opérations différentes. [3]Carbon-X tente de rapprocher deux apprentissages : celui des motifs présents dans l’ADN et celui des connaissances décrites dans les textes scientifiques. L’équipe est partie de Qwen3-14B, puis a combiné données génomiques et textes avant un entraînement destiné à répondre aux questions. Les séquences sont notamment découpées en unités de six bases. Cette représentation donne au modèle une entrée adaptée au matériau biologique. [1]
Des résultats prometteurs, à lire dans leur périmètre
Les auteurs annoncent un score moyen de 66,7 % sur cinq évaluations, contre 67,5 % pour GPT-6.1 Sol dans leur comparaison. Il s’agit de résultats produits par l’équipe, sur les tâches et réglages qu’elle a retenus, et non d’une validation clinique indépendante. Une moyenne proche ne signifie pas que les deux systèmes se valent dans tous les usages. [1]La fiche technique indique que le modèle peut être déployé sur un processeur graphique disposant de 80 Go de mémoire. La licence Apache 2.0 permet sa réutilisation et son adaptation. L’intérêt, pour un laboratoire équipé, est de pouvoir garder les séquences sur son infrastructure ; ce choix suppose toutefois des ressources de calcul et une gestion effective des accès. L’ouverture des poids ne rend pas automatiquement un service externe confidentiel. [2]
Un outil de recherche, pas un diagnostic
Les limites sont explicites : Carbon-X n’a pas été validé cliniquement et ne doit pas servir à prendre des décisions médicales. Il peut confondre des positions, mal compter des bases ou inventer la fonction d’une séquence lorsqu’il manque de contexte. Les opérations exactes doivent donc être vérifiées avec des outils adaptés, et les affirmations biologiques confrontées aux données. [2]L’arbitrage se situe là : rendre une analyse plus accessible n’en supprime pas les étapes de preuve. Pour la recherche, la valeur d’un tel modèle dépendra moins d’une réponse bien formulée que de sa capacité à produire des résultats vérifiables et reproductibles.
Sources
[1] Hugging Face et partenaires,
Présentation de Carbon-X, publication du 22 octobre 2026 ;
historique de mise à disposition daté du même jour.[2] HuggingFaceBio,
Fiche technique et limites, version consultée le 23 octobre 2026.[3] NHGRI / Kris A. Wetterstrand,
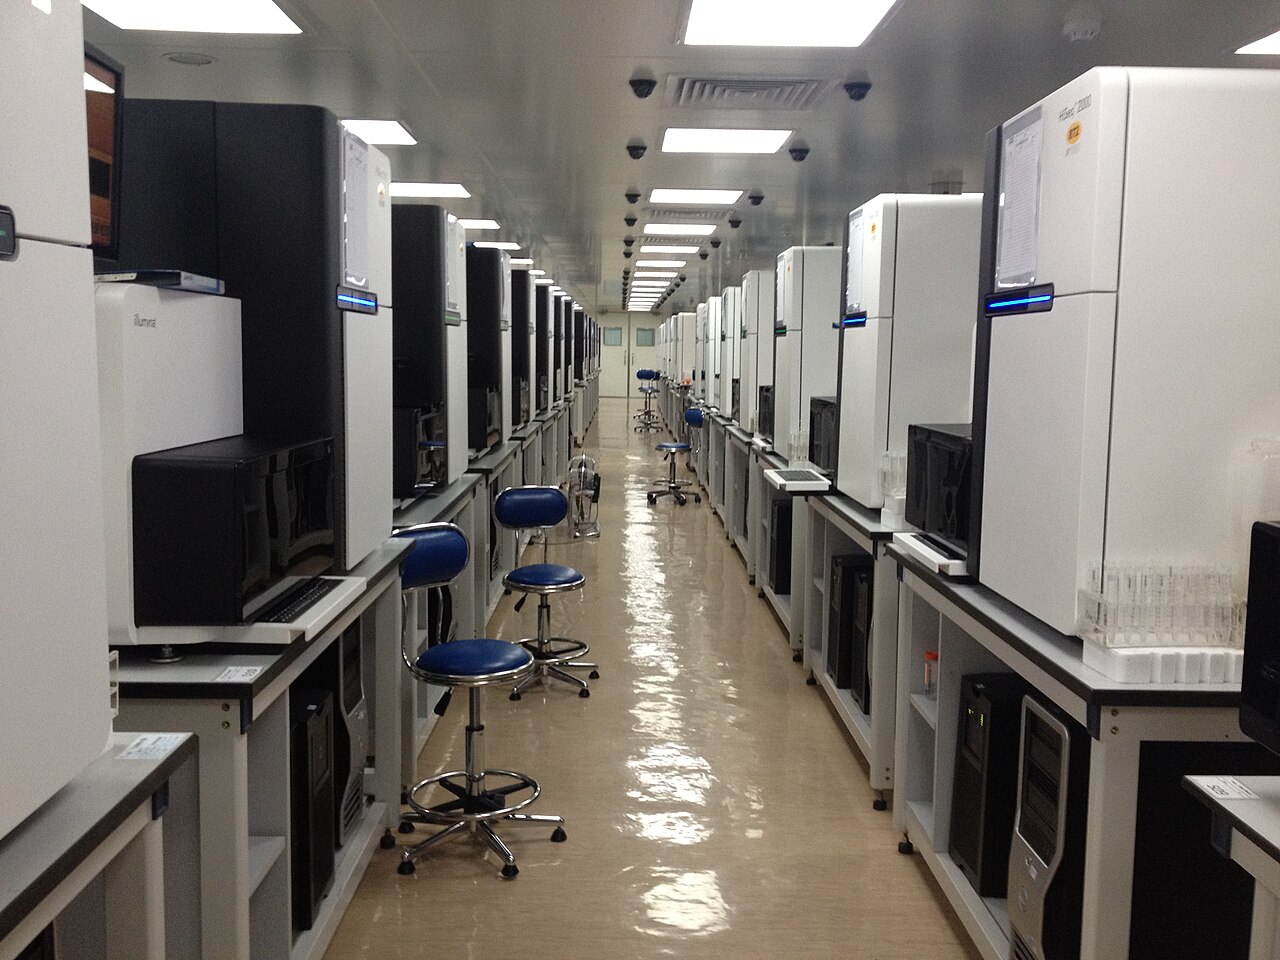
Comprendre le séquençage, mise à jour du 1er novembre 2021 (contexte). Sources consultées le 23 octobre 2026.Photographie d’illustration d’archive : « Illumina Hiseq 2000 sequencers, BGI Hong Kong sequencing room », 11 mars 2013. Elle montre une salle de séquençage, pas une installation de Carbon-X. © Scotted400,
Wikimedia Commons,
CC BY 3.0. Version redimensionnée à 1280 × 960 pixels, sans recadrage par la rédaction.